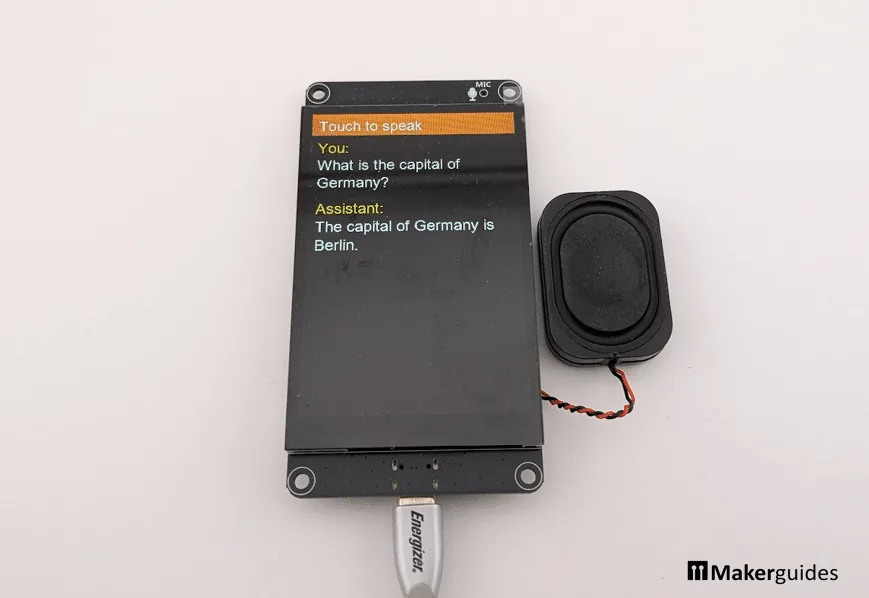
Tocas la pantalla, preguntas en voz alta "¿cuántos grados hay que darle a un servo para que quede al medio?" y unos segundos después la placa te responde hablando, con la pregunta y la respuesta escritas en pantalla. Nada de celular ni parlante inteligente de una marca: un ESP32-S3 que tú programaste, con la personalidad, el idioma y el largo de respuesta que tú decides.
Este tutorial explica cómo funciona un asistente de voz con IA montado sobre la placa Elecrow de 3,5 pulgadas con ESP32-S3, usando los modelos de OpenAI para transcribir, responder y hablar. Más que copiar un proyecto, la idea es que entiendas cada etapa: cómo la placa decide que terminaste de hablar, por qué el audio necesita PSRAM, qué se manda a internet y qué pasa con la clave de la API. Al final vas a saber configurarlo a tu gusto y qué cambiar para llevarlo a un ESP32-S3 genérico con micrófono y amplificador I2S.
La idea en una frase: cinco etapas y una pantalla
Cada interacción (un "turno") pasa siempre por las mismas etapas:
- Espera: la pantalla dice "Touch to speak".
- Captura: grabas tu pregunta en memoria.
- Transcripción: el audio se sube a la API de transcripción y vuelve como texto.
- Respuesta: ese texto va al modelo de chat, que escribe la respuesta.
- Voz: la respuesta se convierte en audio y suena por el parlante.
Al terminar, la pantalla muestra pregunta y respuesta hasta que la vuelvas a tocar.
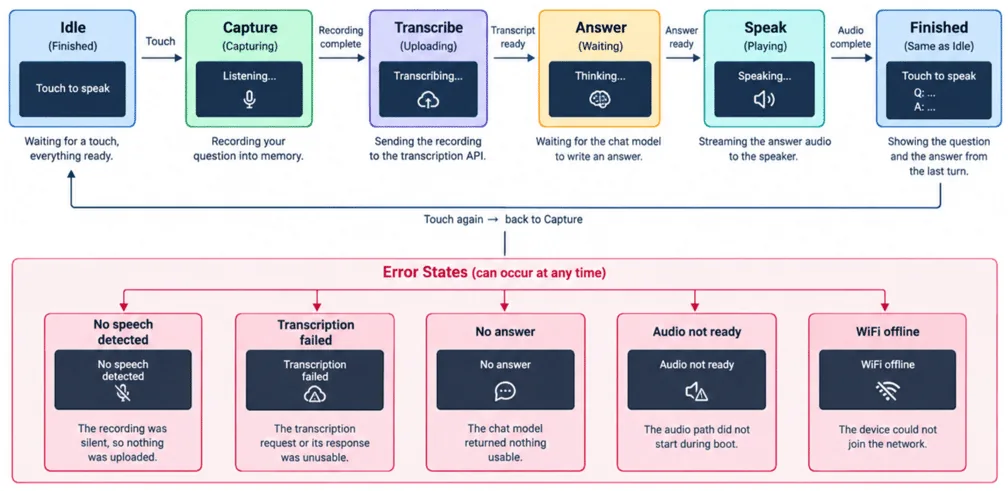
Fíjate en algo importante: el ESP32-S3 no "entiende" nada. Su trabajo es grabar bien, hacer tres pedidos HTTPS en orden y reproducir lo que vuelve. Toda la inteligencia está en los servicios remotos. Por eso el proyecto necesita WiFi y no funciona sin conexión.
El hardware: qué trae la placa y por qué importa
La placa viene con un parlante pequeño, un cable para el conector GPIO de 4 pines y un cable USB-C.
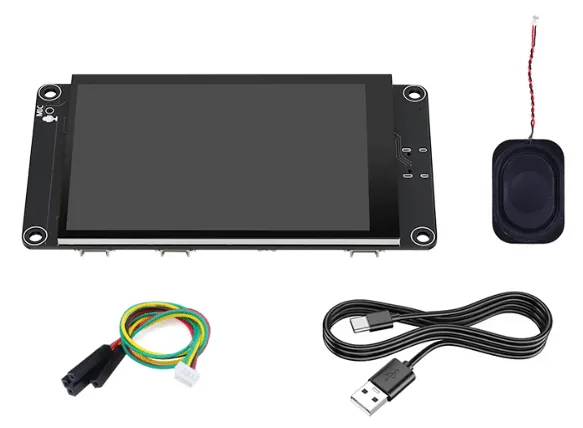
ESP32-S3 N16R8: la "R8" es la que manda
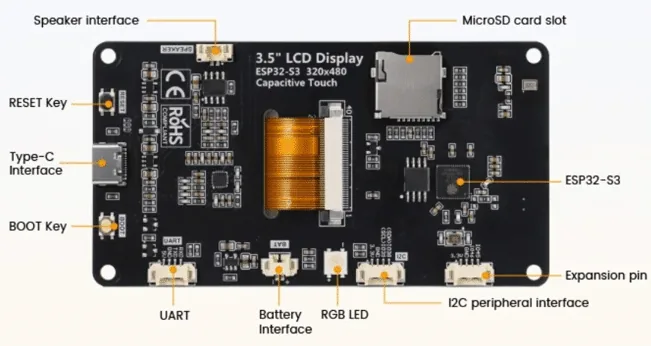
El módulo es un ESP32-S3 de dos núcleos a 240 MHz con 16 MB de flash y 8 MB de PSRAM octal. Para un asistente de voz, esos 8 MB son imprescindibles. Haz la cuenta: audio a 16 kHz y 16 bits ocupa 32 KB por segundo, así que una pregunta de 10 segundos son 320 KB, y la respuesta hablada puede pesar varias veces eso. La RAM interna del ESP32-S3 (512 KB de SRAM, compartida con WiFi, TLS y la pantalla) no alcanza. Los dos buffers grandes de audio viven en la PSRAM.
La radio es solo de 2,4 GHz: tu red WiFi tiene que ofrecer esa banda.
Pantalla y touch
Es una IPS de 3,5" y 320 × 480 con controlador ST77922 por QSPI a 80 MHz, suficiente para mandar un cuadro completo de una vez. El firmware dibuja primero en un buffer y después envía el cuadro terminado: así no se ve el parpadeo de borrar y redibujar por partes. El touch es capacitivo, por I2C, y aunque puede reportar hasta diez dedos, el asistente solo usa "hay un dedo o no".
El audio: codec, micrófono y amplificador
Son tres piezas. Un codec ES8311 convierte entre audio analógico y muestras digitales I2S; un micrófono de alta sensibilidad entra al codec; y un amplificador clase D mono mueve el parlante (hasta 1,5 W en 8 Ω o 2 W en 4 Ω, por un conector de 1,25 mm). El codec trabaja en las dos direcciones con un solo reloj y una sola frecuencia de muestreo, lo que simplifica mucho el código: grabar y reproducir usan el mismo camino.
El amplificador tiene su propio pin de habilitación. El firmware lo enciende solo antes de hablar: así el parlante no hace ruido al arrancar y el amplificador no consume mientras el asistente espera.
Bus I2C compartido: la trampa de la placa
El touch, el codec de audio y el conector I2C externo comparten el mismo bus (IO38 y IO39). Funciona porque cada uno tiene su dirección, pero nunca se debe hablar con dos de ellos al mismo tiempo desde tareas distintas. Si agregas un sensor por el conector externo y lo lees desde otra tarea mientras el código configura el codec, vas a tener errores raros. La regla: todo acceso a ese bus, desde un solo lugar.
Energía, LED y botones
Se alimenta por USB-C o con una batería LiPo de una celda por un conector de 1,25 mm de 2 pines. El cargador limita a 500 mA (en la práctica, unos 290 mA) y es normal que la placa se entibie al cargar. Un divisor de voltaje permite medir la batería. Hay dos reguladores de 3,3 V: uno para lo digital y otro más limpio para el audio analógico, un detalle que se nota en el ruido de fondo del micrófono.
Trae además una ranura microSD en modo de 4 bits, un LED RGB direccionable y dos botones: reset y BOOT, que también sirve como tecla normal (un candidato para "apretar para hablar").
Pines que te van a importar
| Función | Pines |
|---|---|
| Pantalla QSPI | IO10 (CS), IO12 (reloj), IO11, IO13, IO14, IO9 (datos) |
| Luz de fondo | IO41 |
| I2C compartido (touch, codec, conector) | IO38 (SDA), IO39 (SCL) |
| Touch: reset e interrupción | IO48, IO47 |
| Audio I2S | IO17 (MCLK), IO18 (BCLK), IO21 (LRCK), IO16 (salida), IO15 (entrada) |
| Habilitación del amplificador | IO1 (activo en bajo) |
| LED RGB | IO40 |
| Batería (ADC) | IO8 |
| Pines libres del conector | IO45, IO46 |
Cómo sabe que terminaste de hablar
Tocas la pantalla una sola vez, y el equipo decide solo cuándo terminó tu pregunta. Lo hace con detección de actividad de voz (VAD), en su versión más simple: mirar el volumen.
- Empieza a grabar en serio cuando el volumen supera un umbral (
VAD_THRESHOLD). - Termina cuando, después de haber oído voz, viene un silencio corto.
- Corta por límite si llega a la duración máxima (
MAX_RECORD_SECS), aunque sigas hablando. - Se rinde si no oye nada durante unos segundos tras el toque: muestra "No speech detected" y no sube nada. Así un toque accidental no deja el equipo colgado ni gasta una llamada a la API.
Por qué a veces se come la primera palabra. Si empiezas a hablar muy suave, las primeras sílabas quedan bajo el umbral y no se guardan. La solución clásica es un pequeño "pre buffer": guardar siempre el último medio segundo y, cuando se cruza el umbral, incluirlo en la grabación. Si no quieres tocar código, baja VAD_THRESHOLD o empieza con una palabra más fuerte.
El umbral depende de tu pieza. Con un ventilador o un aire acondicionado al lado, el ruido de fondo puede quedar sobre el umbral y la grabación no termina nunca (hasta el límite máximo). Prueba primero en silencio, mira en el monitor serie los niveles que reporta y ajusta.
Lo que ves en pantalla
La pantalla es el único indicador del equipo, así que nombra cada estado con palabras:
| Texto | Qué está pasando |
|---|---|
| Touch to speak | Esperando (o mostrando el último turno) |
| Listening… | Grabando tu pregunta |
| Transcribing… | Subiendo el audio a la transcripción |
| Thinking… | Esperando la respuesta del modelo |
| Speaking… | Reproduciendo la respuesta |
| No speech detected | Grabación en silencio, no se subió nada |
| Transcription failed | La transcripción falló o vino inutilizable |
| No answer | El modelo no devolvió nada útil |
| Audio not ready | El audio no arrancó al encender |
| WiFi offline | No se pudo conectar a la red |
El software, por dentro
El código está en el repositorio del autor (enlace en Recursos) y se compila con PlatformIO en VS Code. Cada archivo lleva el nombre de la etapa que resuelve, no de la tecnología:
| Archivo | Qué hace |
|---|---|
src/main.cpp |
Arranca todo y corre un turno de principio a fin |
src/app_config.h |
Configuración: modelos, pines, tiempos, volumen, endpoints |
src/display_ui.* |
Pantalla, buffer, touch, diseño y ajuste de texto |
src/audio_io.* |
Grabar y reproducir por un solo bus I2S y un codec |
src/openai_http.* |
Transporte HTTPS: clave, tiempos de espera, formatos de pedido |
src/stt.* |
Voz a texto: arma la subida y lee la transcripción |
src/llm.* |
Chat: arma el pedido y lee la respuesta |
src/tts.* |
Texto a voz: pide el audio, lo guarda y se lo pasa al audio |
src/latin1_font.h |
Fuente con todo Latin-1, para que se vean tildes y eñes |
En lib/ vienen los drivers locales (ES8311, ST77922, ST77922_TOUCH) y una copia modificada de la librería de audio audio-tools. Esa modificación importa: si la reemplazas por una descarga nueva, se pierde el gancho que lee una de las opciones de compilación (más abajo) y el audio sale mal sin dar error.
Dónde cambiar qué
| Quiero cambiar… | Edito |
|---|---|
| Personalidad, tono o idioma | LLM_SYSTEM_PROMPT en src/app_config.h |
| La voz | TTS_VOICE |
| El largo de las respuestas | LLM_SYSTEM_PROMPT y LLM_MAX_TOKENS |
| Cuánto puede durar una pregunta | MAX_RECORD_SECS |
| Sensibilidad del micrófono | VAD_THRESHOLD |
| Volumen | OUTPUT_VOLUME_PERCENT |
| Los modelos | TRANSCRIBE_MODEL, LLM_MODEL y TTS_MODEL |
| Proveedor o endpoint | OPENAI_HOST y las tres rutas |
| WiFi y clave de la API | include/credentials.h |
Las opciones de compilación que pueden arruinarte el audio
En platformio.ini hay tres opciones de compilación. Dos son conocidas (ARDUINO_USB_MODE=1 y ARDUINO_USB_CDC_ON_BOOT=1, para que el monitor serie funcione desde el arranque). La tercera es la que más problemas da:
AUDIO_TOOLS_I2S_MCLK_MULTIPLE=I2S_MCLK_MULTIPLE_384
El reloj maestro I2S (MCLK) tiene que ser un múltiplo exacto de la frecuencia de muestreo. La librería de audio usa 256 por defecto, pero el driver del codec lo configura para 384. A 16 kHz eso es 6,144 MHz. Si los dos no coinciden, el codec recibe un reloj que no esperaba y la voz sale estirada, apurada o como de robot. Si alguna vez oyes eso, revisa esta opción antes que cualquier otra cosa.
Las opciones de memoria también importan: board_build.arduino.memory_type = qio_opi es la combinación que deja flash y PSRAM disponibles a la vez. Si está mal, los buffers de audio no se pueden reservar y el equipo muestra un error al arrancar.
Por qué un solo buffer contiguo
La transcripción se sube como un único pedido HTTP con el audio dentro de un contenedor WAV. El firmware reserva en la PSRAM un solo bloque continuo para todo el cuerpo del pedido, con el audio ya envuelto en su contenedor, y lo manda de una vez. Es más simple y más rápido que mandar en trozos, y evita fragmentar la memoria con muchas reservas chicas.
Respuestas sin memoria
Cada pregunta va sola al modelo, con la instrucción de sistema y nada más. El asistente no recuerda lo que preguntaste antes. Es una decisión de diseño: mantiene el pedido chico, rápido y barato. Si quieres conversación con contexto, hay que guardar los últimos turnos y mandarlos junto con la pregunta nueva, sabiendo que cada pedido se vuelve más largo.
Configurarlo: credenciales e instrucción de sistema
La clave de la API
WiFi, contraseña y clave de OpenAI van en include/credentials.h, un archivo que no está en el repositorio a propósito (el proyecto no compila hasta que lo crees). El tutorial original trae la plantilla: tres constantes, una para el nombre de la red, otra para su contraseña y otra para la clave.
La clave de la API es una credencial pagada: cada transcripción, respuesta y audio se cobra a la cuenta dueña. Tres reglas:
- No la compartas ni la subas a un repositorio. Si se filtra, revócala y crea otra.
- Crea una clave solo para este proyecto y ponle límite de gasto a la cuenta. Si algo se queda en bucle, el daño queda acotado.
- Recuerda que vive dentro del firmware. Cualquiera con la placa en la mano y paciencia puede leerla de la flash. Para un aparato de escritorio propio está bien; para algo que vas a regalar o dejar en un lugar público, no.
Hacerlo hablar en español de Chile
La personalidad entera está en LLM_SYSTEM_PROMPT. Una instrucción como "Eres un asistente de electrónica. Responde en español de Chile, con tuteo, en dos o tres oraciones como máximo, sin listas ni formato" cambia por completo la experiencia. Respuestas cortas no son solo más cómodas: el audio pesa menos, se descarga antes y la espera total baja. Ajusta también LLM_MAX_TOKENS como tope duro.
La transcripción reconoce español sin configuración extra, y la voz de síntesis lee en español si el texto viene en español. Cambia TTS_VOICE hasta encontrar una que te suene natural.
El volumen
OUTPUT_VOLUME_PERCENT controla la ganancia digital. El parlante incluido es chico: si subes demasiado, distorsiona antes de sonar más fuerte. Si necesitas más volumen, cambia el parlante por uno más grande (el amplificador entrega hasta 2 W en 4 Ω) en vez de subir el porcentaje.
Sobre los certificados
El cliente HTTPS del proyecto no valida el certificado del servidor. La conexión va cifrada igual, pero en teoría alguien en tu misma red podría hacerse pasar por el servidor y capturar la clave. Para mejorarlo, carga el certificado raíz de la API en el firmware y actívale la validación al cliente TLS.
Compilar, subir y probar
- Instala VS Code y la extensión PlatformIO IDE. La primera compilación descarga varios cientos de MB (plataforma ESP32 y framework Arduino): paciencia.
- Clona el repositorio y ábrelo en VS Code.
- Crea
include/credentials.hcon tus datos. - Conecta la placa por USB-C (cable de datos), elige el puerto y sube el firmware.
- Abre el monitor serie a 115200. Al arrancar deberías ver la conexión a la red y el audio listo. Durante los turnos el registro queda callado salvo que algo falle: solo se anotan los errores, para no llenar el monitor.
Un turno completo suele tardar unos segundos, y casi todo ese tiempo es red: subir el audio, esperar la respuesta y bajar la voz.
Errores comunes
- Error al arrancar por memoria. La PSRAM no está habilitada: revisa
qio_opienplatformio.ini. - La voz suena estirada o como robot. El múltiplo del MCLK no calza (la opción
I2S_MCLK_MULTIPLE_384) o reemplazaste la copia modificada deaudio-tools. - "WiFi offline". Red de 5 GHz, contraseña mal escrita o señal débil.
- "Transcription failed" o "No answer". Clave revocada, cuenta sin saldo o límite alcanzado. El monitor serie muestra el código de error HTTP.
- No termina de grabar. Ruido de fondo sobre el umbral: sube
VAD_THRESHOLD. - Se come la primera palabra. Umbral alto o falta de pre buffer (ver arriba).
Variantes y mejoras
- Llevarlo a un ESP32-S3 genérico. El proyecto está atado a la Elecrow por el codec ES8311, la pantalla ST77922 y sus pines, pero la arquitectura por etapas se porta bien. Con una XIAO ESP32 S3 (también trae 8 MB de PSRAM), un micrófono I2S INMP441 y un amplificador I2S MAX98357A con un parlante de 8 Ω, el cambio se concentra en tres lugares. En
src/app_config.h, los pines nuevos. Ensrc/audio_io.*, la configuración: ya no hay codec que configurar por I2C ni MCLK, porque los dos módulos son I2S puros. Pueden compartir reloj de bit y selección de canal, con el micrófono en la entrada de datos y el amplificador en la salida, a la misma frecuencia de 16 kHz. Ojo con que el INMP441 entrega muestras de 24 bits en ranuras de 32, así que hay que bajarlas a 16 bits antes de armar el WAV, y su pin L/R a GND lo deja en el canal izquierdo. Y ensrc/display_ui.*, reemplazar la pantalla por mensajes en el monitor serie o una OLED chica, con un botón en vez del touch. - Apretar para hablar. Usa el botón BOOT como disparador en vez de la pantalla. Es más rápido y evita toques accidentales.
- Indicador sin mirar. Usa el LED RGB para el estado: azul escuchando, amarillo pensando, verde hablando, rojo error. Sirve cuando la placa queda lejos o de costado.
- Respuestas con datos tuyos. Pon un sensor de temperatura en el conector I2C (desde la misma tarea que maneja el bus) y agrega la lectura a la instrucción de sistema en cada turno. Así "¿hace frío en el taller?" tiene respuesta real.
Personalización para Chile
En MechatronicStore consigues lo que acompaña a la placa y las piezas para llevarla a un ESP32-S3 genérico:
- Cable USB Tipo C a USB Tipo A 1mt (SKU B-101): para subir el firmware y ver el monitor serie. Tiene que ser de datos.
- Batería LiPo 852540 3.7V 600mAh (SKU GE1-11): para usarlo sin cable. Revisa el conector antes de enchufar: la placa usa uno de 1,25 mm de 2 pines y la polaridad tiene que coincidir; si no calza, cambia el conector en vez de forzarlo.
- Seeed Studio XIAO ESP32 S3 (SKU GS1-3): la base de la versión genérica, con 8 MB de PSRAM para los buffers de audio y WiFi.
- Módulo Micrófono I2S INMP441 (SKU GL3-12): el micrófono digital de la versión genérica.
- Parlante altavoz 8 Ohm 1W 50mm (SKU G-107): un parlante algo más grande que el incluido, para la versión genérica o para reemplazar el de la Elecrow.
La placa Elecrow de 3,5" no está en el catálogo, y el amplificador I2S MAX98357A de la versión genérica tampoco. Si quieres una pantalla táctil con ESP32 del catálogo para otros proyectos, está la ESP32 WROOM con Pantalla LCD Táctil 2.8" LVGL (SKU D-517), pero ojo: es un ESP32 clásico sin la PSRAM que este asistente necesita, así que no sirve para este proyecto tal cual.
Recursos
- Tutorial original (inglés): AI Voice Assistant Using the Elecrow 3.5 Inch ESP32-S3 Display, de Makerguides, con la plantilla de
credentials.hy la explicación del código archivo por archivo. - Repositorio GitHub: voice assistant elecrow esp32-s3-display
- Configuración de compilación: platformio.ini
- Drivers de la placa: ES8311, ST77922 y ST77922_TOUCH
- Documentación de la placa: wiki de Elecrow y manual de usuario (PDF)
- Entorno de desarrollo: PlatformIO para VS Code
Versión chilena basada en el tutorial de Makerguides, con componentes en stock local.