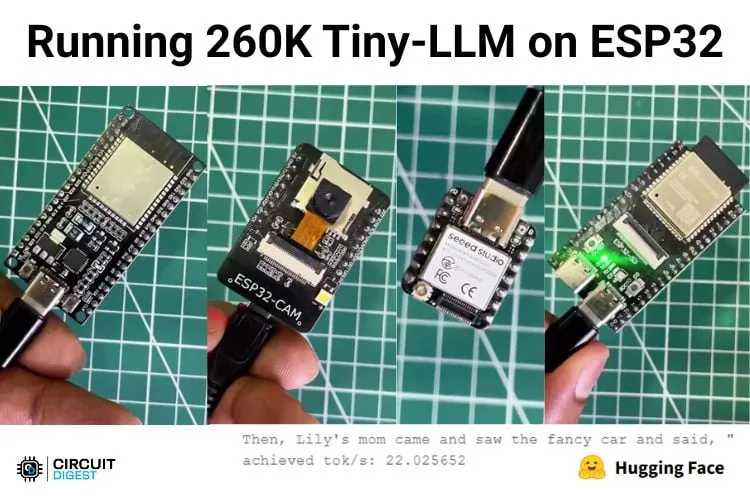
¿Se puede meter un modelo de lenguaje, de esos que escriben texto palabra por palabra, dentro de un microcontrolador que cuesta lo mismo que un almuerzo? La respuesta corta es sí, siempre que el modelo sea diminuto. La respuesta interesante es otra: la placa que elijas cambia la velocidad casi diez veces, y la razón no es el procesador, es la memoria.
En esta guía vas a cargar el Tiny LLM de 260.000 parámetros que publicó Andrej Karpathy junto a su proyecto llama2.c (un motor de inferencia escrito en C puro) en cuatro placas ESP32 distintas, y vas a comparar cuántos tokens por segundo genera cada una. Al terminar vas a saber:
- Cómo subir archivos que no son código (los pesos del modelo) a la Flash del ESP32 con LittleFS.
- Qué configurar en Arduino IDE para que la PSRAM quede activa.
- Por qué la PSRAM es el factor que manda cuando corres IA generativa en el borde.
- Qué ESP32 conviene comprar según el tipo de proyecto de IA que tengas en mente.
La idea en un minuto: por qué la memoria manda
Un modelo de lenguaje genera texto de a un token (un trozo de palabra) por vez. Para producir cada token tiene que recorrer todos sus pesos: multiplica el estado actual por cada matriz del modelo. Con 260.000 parámetros guardados en float32 (4 bytes cada uno), eso es alrededor de 1 MB de datos que hay que leer por token.
El ESP32 clásico tiene unos 520 KB de SRAM interna, así que el modelo completo no cabe en la memoria rápida. Quedan dos caminos:
- Leer los pesos directo desde la Flash SPI en cada pasada. Funciona en cualquier ESP32, pero la Flash es lenta para lecturas repetidas y el sistema de archivos agrega su propio costo.
- Copiar los pesos una vez a la PSRAM (RAM externa que traen algunas placas) y leerlos desde ahí. La PSRAM es mucho más rápida que la Flash, sobre todo la PSRAM octal del ESP32-S3.
Por eso la cuenta es casi directa: si cada token exige leer ~1 MB, los tokens por segundo quedan limitados por cuántos MB por segundo entrega la memoria. Los resultados de más abajo lo confirman.
Las cuatro placas del banco de pruebas
| Placa | Flash | PSRAM | Qué representa |
|---|---|---|---|
| ESP32 DevKit V1 | 4 MB | 0 MB | La placa más común, sin RAM externa |
| ESP32-CAM | 4 MB | 4 MB | ESP32 clásico con PSRAM quad SPI |
| Seeed XIAO ESP32-S3 | 8 MB | 8 MB | ESP32-S3 compacto con PSRAM octal |
| ESP32-S3 DevKit (N16R8) | 16 MB | 8 MB | ESP32-S3 de desarrollo con PSRAM octal |
Todas las placas tienen Flash, pero la PSRAM es opcional según el modelo. Si todavía no compras, este detalle es el que tienes que mirar en la ficha: la sigla N16R8 significa 16 MB de Flash (N16) y 8 MB de PSRAM (R8).
Hay una diferencia con los proyectos de siempre: además del sketch .ino, esta vez tienes que grabar archivos de datos (el modelo y el tokenizador) en la Flash. Eso se hace en todas las placas, tengan PSRAM o no.
Hardware: paso a paso
1. Descarga el modelo y el tokenizador
Entra a la página de Andrej Karpathy en Hugging Face, al modelo stories260K, y descarga dos archivos con el botón de descarga que está a su derecha:
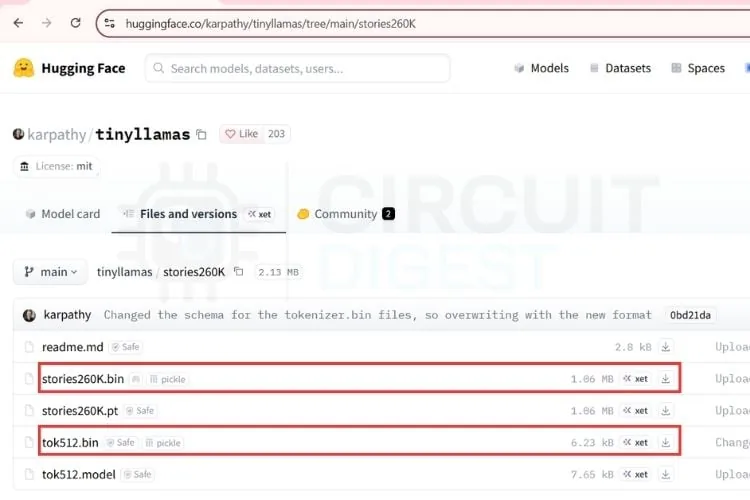
stories260K.bin: los pesos entrenados del modelo en binario crudo. Es lo que lee el motor en C.tok512.bin: el tokenizador en formato binario. Le dice arun.ccómo traducir los números que genera el modelo a letras y palabras en inglés.
Vas a ver otros dos archivos que no necesitas: stories260K.pt (los mismos pesos en formato PyTorch, útil solo para reentrenar o analizar el modelo en Python) y tok512.model (el tokenizador que usan las librerías de Python antes del entrenamiento).
Ajusta tus expectativas: el modelo se entrenó con el dataset TinyStories, que usa el vocabulario de un niño de 3 a 4 años. Con ~1 MB de tamaño no vas a obtener literatura, vas a obtener frases simples en inglés. El valor del experimento es medir, no leer cuentos.
2. Arma la estructura de carpetas
El plugin que sube archivos a la Flash busca una carpeta con un nombre exacto. Deja así el proyecto:
- En la carpeta del sketch van el
.inoy elrun.c. - Dentro de esa misma carpeta crea una subcarpeta llamada
datay guarda ahístories260K.binytok512.bin.
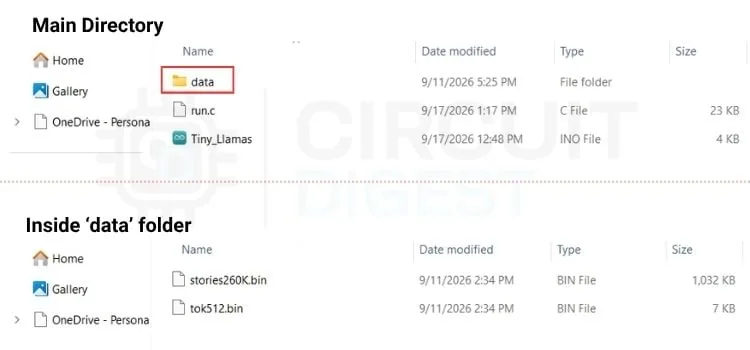
Si no quieres armarlo a mano, el repositorio de GitHub del proyecto (enlazado al final) ya trae el código y los modelos ordenados.
3. Sube los pesos a la Flash con LittleFS
Arduino IDE solo sube código por defecto. Para grabar archivos de datos necesitas el plugin Arduino LittleFS Upload de Earle Philhower, que sirve para ESP8266, ESP32 y RP2040.
- En la página de releases del plugin descarga el archivo
.vsixmás reciente (al escribir el original eraarduino-littlefs-upload-1.6.3.vsix). - Cópialo en la carpeta de plugins de Arduino IDE 2: en Windows es
C:\Users\<tu usuario>\.arduinoIDE\plugins(créala si no existe). Si al ejecutarlo da error, prueba dejándolo directamente enC:\Users\<tu usuario>\.arduinoIDE. En Linux y macOS la ruta equivalente es~/.arduinoIDE/plugins. - Reinicia Arduino IDE, conecta la placa, abre la paleta de comandos con
Ctrl + Shift + Py elige Upload LittleFS to Pico/ESP8266/ESP32. - Espera a que la terminal del plugin diga Completed Upload.
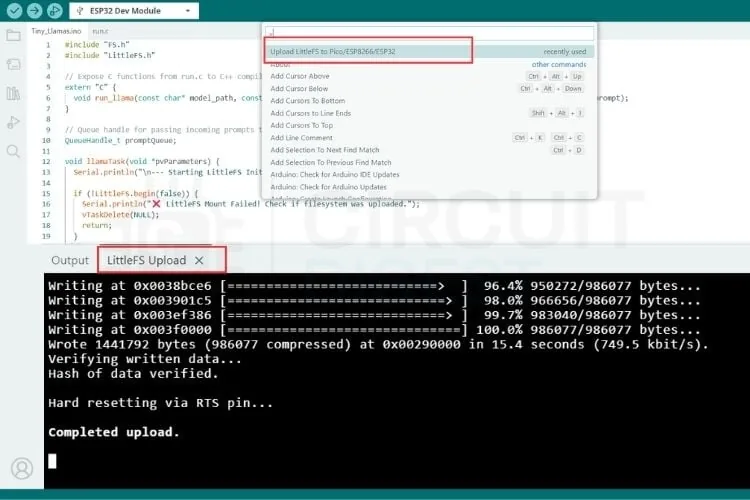
Si aparece un error, el 90 % de las veces es la carpeta: que no se llame exactamente data o que no esté al lado del .ino. Un segundo motivo común es tener el monitor serie abierto, que deja el puerto ocupado; ciérralo antes de subir.
Algo importante que el plugin no te dice: el tamaño del sistema de archivos lo define el esquema de particiones que elijas en el paso siguiente. Si la partición de LittleFS es más chica que ~1,1 MB, los archivos no caben. Por eso conviene fijar la configuración de la placa antes de subir los datos.
4. Configura Flash y PSRAM en Arduino IDE
En el menú Herramientas ajusta el tamaño de Flash, el esquema de particiones y la PSRAM según tu placa exacta:
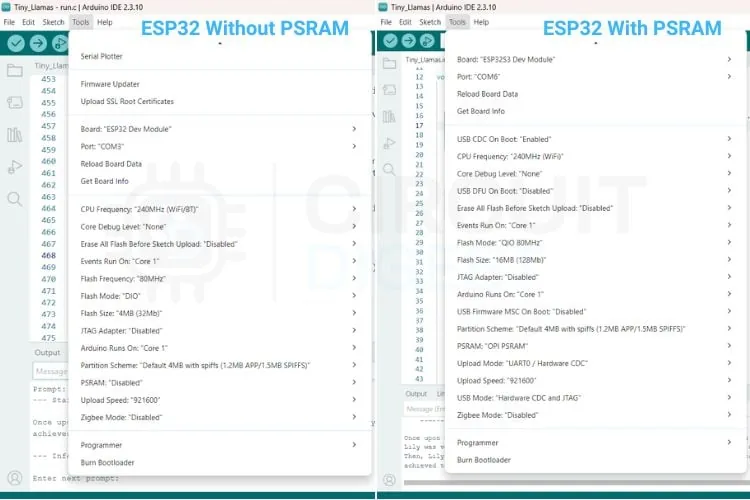
- ESP32 DevKit V1: Flash de 4 MB y PSRAM desactivada.
- ESP32-S3 N16R8: Flash de 16 MB y PSRAM en modo OPI (octal). Si eliges QSPI en una placa octal, la PSRAM no arranca.
- XIAO ESP32-S3: selecciona la placa de Seeed y activa la PSRAM OPI.
- ESP32-CAM: la placa "AI Thinker ESP32-CAM" ya trae la PSRAM activada.
Hay un detalle del repositorio que conviene saber: el run.c para placas sin PSRAM está en una carpeta aparte llamada run.c code for ESP32 without PSRAM. Si tu ESP32 no tiene PSRAM usa ese; si la tiene, usa el de la carpeta principal. Con eso listo, presiona el botón de subir.
Software: qué hace el código
El sketch tiene dos partes: el .ino, que maneja el sistema de archivos, el puerto serie y las tareas de FreeRTOS, y el run.c, que es el motor de inferencia de llama2.c adaptado. Estos son los bloques clave del .ino (el archivo completo está en el repositorio).
Librerías y puente hacia C. El motor está escrito en C puro, así que el sketch en C++ necesita declarar la función con extern "C" para poder enlazarla:
#include "FS.h"
#include "LittleFS.h"
// Expose C functions from run.c to C++ compiler
extern "C" {
 void run_llama(const char* model_path, const char* tokenizer_path, float temperature, float topp, int steps, const char* prompt);
}
La tarea que corre el modelo. Todo el trabajo pesado vive en una tarea de FreeRTOS. Primero monta la Flash y revisa que los dos archivos estén:
void llamaTask(void *pvParameters) {
 Serial.println("\n--- Starting LittleFS Initialization ---");
 if (!LittleFS.begin(false)) {
   Serial.println("LittleFS Mount Failed! Check if filesystem was uploaded.");
   vTaskDelete(NULL);
   return;
 }
 Serial.println("LittleFS Mounted Successfully.");

 if (!LittleFS.exists("/stories260K.bin")) {
   Serial.println("Error: /stories260K.bin not found on LittleFS!");
   vTaskDelete(NULL);
   return;
 }

 if (!LittleFS.exists("/tok512.bin")) {
   Serial.println("Error: /tok512.bin not found on LittleFS!");
   vTaskDelete(NULL);
   return;
 }
LittleFS.begin(false)monta el sistema de archivos. Elfalseevita que lo formatee si falla el montaje, así no pierdes los archivos que subiste.LittleFS.exists()busca los dos binarios que subiste desde la carpetadata. Si falta alguno, lo dice por serie.vTaskDelete(NULL)termina la tarea de forma limpia si algo falla, en vez de dejar el micro colgado.
setup(): detectar la PSRAM. Al arrancar, el programa informa en qué modo va a trabajar:
void setup() {
 Serial.begin(115200);
 delay(2000); // Allow hardware serial connection to settle
 Serial.println("==========================================");
 Serial.println("   ESP32-S3 Tiny Llama Inference Engine   ");
 Serial.println("==========================================");
 // Non-blocking memory mode log
 if (ESP.getPsramSize() == 0) {
   Serial.println("ℹ️ PSRAM not detected. Running in Flash-Streaming mode.");
 } else {
   Serial.printf("PSRAM Available: %d Bytes\n", ESP.getFreePsram());
 }
Si ESP.getPsramSize() devuelve 0, el modelo corre en modo Flash Streaming. Si hay PSRAM, muestra cuántos bytes quedan libres. Este mensaje es tu primera verificación: si tu placa tiene PSRAM y el monitor dice que no la detecta, revisa la opción de PSRAM del paso 4.
loop(): el prompt desde el monitor serie. Mientras la tarea del modelo trabaja en un núcleo, el loop() escucha lo que escribes:
void loop() {
 // Read typed text from the Serial Monitor
 if (Serial.available() > 0) {
   String inputString = Serial.readStringUntil('\n');
   inputString.trim(); // Strip carriage returns and spaces
   if (inputString.length() > 0) {
     char promptBuffer[256];
     inputString.toCharArray(promptBuffer, sizeof(promptBuffer));
     // Push user text into queue for llamaTask to consume
     xQueueSend(promptQueue, &promptBuffer, pdMS_TO_TICKS(100));
   }
 }
 vTaskDelay(pdMS_TO_TICKS(50)); // Poll serial smoothly
}
Serial.readStringUntil('\n')ytrim()leen la línea y le sacan espacios y retornos de carro.toCharArray()la convierte en un arreglo decharal estilo C, que es lo que entienderun.c.xQueueSend()deja el prompt en la colapromptQueue(con 100 ms de espera máxima) y la tarea del modelo lo toma para la siguiente inferencia.vTaskDelay(pdMS_TO_TICKS(50))cede el procesador unos milisegundos para que el watchdog no reinicie el chip.
Separar la inferencia en una tarea propia no es un capricho: una pasada del modelo tarda cientos de milisegundos en la placa más lenta, y si corriera dentro de loop() el puerto serie dejaría de responder mientras tanto.
Pruebas: los resultados
Con el código cargado abre el monitor serie a 115200 baudios. Apenas el IDE detecta la placa, el modelo empieza a escribir una historia por defecto y, al terminar, imprime los tokens por segundo.
En teoría puedes escribir el comienzo de una historia y el modelo la continúa. En la práctica no respeta mucho el prompt: es un modelo de 1 MB, no un LLM de verdad. Pero genera palabras y te da una métrica limpia para comparar hardware, que es lo que buscamos.
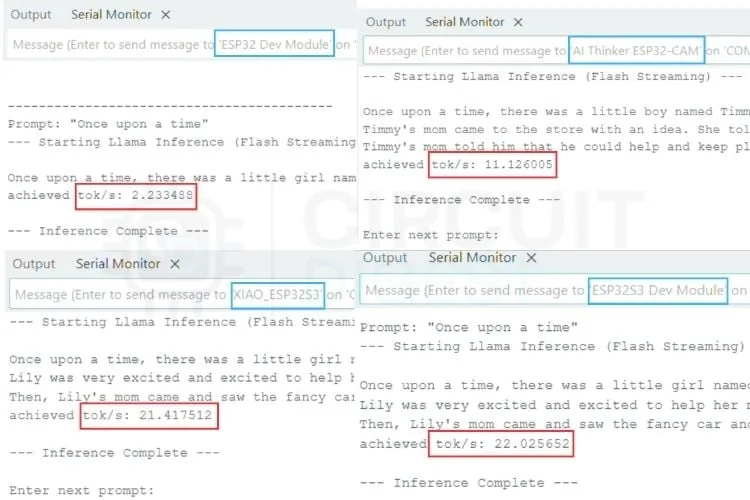
| Placa | Flash | PSRAM | Velocidad | Cuello de botella probable |
|---|---|---|---|---|
| ESP32 DevKit V1 | 4 MB | 0 MB | 2,33 tok/s | Lectura desde la Flash a través del sistema de archivos |
| ESP32-CAM | 4 MB | 4 MB | 11,12 tok/s | PSRAM quad SPI del ESP32 clásico |
| Seeed XIAO ESP32-S3 | 8 MB | 8 MB | 21,41 tok/s | PSRAM octal; empieza a pesar el cálculo |
| ESP32-S3 DevKit (N16R8) | 16 MB | 8 MB | 22,02 tok/s | PSRAM octal; empieza a pesar el cálculo |
Leyendo la tabla con la idea del principio:
- Sin PSRAM (2,33 tok/s): como cada token exige recorrer ~1 MB de pesos, eso equivale a leer del orden de 2 a 3 MB por segundo desde la Flash. Funciona, pero es lento.
- ESP32-CAM (11,12 tok/s): el mismo procesador que la DevKit V1, solo que con PSRAM. Casi 5 veces más rápido. Esta fila aísla el efecto de la memoria: el núcleo no cambió.
- ESP32-S3 (21-22 tok/s): la PSRAM octal del S3 transfiere el doble de bits por ciclo que la quad del ESP32 clásico, y el núcleo Xtensa LX7 del S3 es además más eficiente en operaciones de punto flotante. Resultado: casi 10 veces la velocidad de la placa sin PSRAM.
- XIAO contra N16R8: prácticamente iguales. Los dos usan el mismo chip con 8 MB de PSRAM octal; los 8 MB de Flash extra de la N16R8 no aceleran nada, porque el modelo ya vive en la PSRAM. La diferencia de 0,6 tok/s entra en el margen de una medición a otra.
La conclusión práctica: para IA generativa en un microcontrolador, la PSRAM (y su tipo) importa más que la Flash o que la frecuencia del CPU.
Errores comunes y cómo resolverlos
- "LittleFS Mount Failed! Check if filesystem was uploaded.": no subiste los datos, o cambiaste el esquema de particiones después de subirlos. Vuelve a correr el Upload LittleFS con la configuración definitiva.
- "Error: /stories260K.bin not found on LittleFS!": la carpeta no se llamaba
data, o los archivos quedaron dentro de otra subcarpeta. Deben quedar en la raíz dedata. - La placa tiene PSRAM pero el monitor dice "PSRAM not detected": la opción de PSRAM está desactivada o en el modo equivocado (QSPI en vez de OPI en la S3).
- Reinicios en bucle al empezar a generar: estás usando el
run.ccon PSRAM en una placa que no la tiene. Cambia al de la carpeta para placas sin PSRAM. - La ESP32-CAM no entra en modo de programación: necesitas su placa programadora (ESP32-CAM MB) o poner GPIO0 a GND durante el reinicio.
Cómo elegir tu ESP32 para proyectos de IA
| Tu proyecto | Placa recomendada | Por qué |
|---|---|---|
| Probar el concepto con lo que tienes en el cajón | ESP32 DevKit V1 | Funciona sin PSRAM, aunque lento |
| IA más cámara (detección de objetos, visión) | ESP32-CAM | PSRAM incluida y cámara en la misma placa |
| Proyecto portátil o wearable | XIAO ESP32-S3 | Misma velocidad que la S3 grande en una placa del tamaño de un pulgar |
| Desarrollo serio de TinyML, modelos más grandes | ESP32-S3 N16R8 | 16 MB de Flash para guardar varios modelos y 8 MB de PSRAM octal |
Variantes y mejoras
- Cuantiza el modelo a 8 bits. El repositorio llama2.c incluye una versión del motor para pesos cuantizados en
int8. Un modelo cuantizado pesa cerca de un cuarto que enfloat32, y si la velocidad depende de cuántos bytes lees por token, en la placa sin PSRAM la mejora debería notarse mucho. Es un buen experimento para medir tu propia hipótesis. - Muestra la historia en una pantalla. Cambia los
Serial.printde la salida por una pantalla OLED SSD1306 por I2C y tendrás un "narrador" autónomo que no necesita el computador. - Clasificador de intenciones sin internet. El original apunta a este uso: en vez de historias, entrena o ajusta un modelo diminuto para reconocer órdenes cortas ("enciende la luz", "sube la persiana") y dispara relés desde el ESP32-S3, todo sin mandar datos a la nube.
- Mide energía por token. Pon un medidor USB entre el computador y la placa y calcula cuántos milijoules gasta cada token en cada ESP32. Para proyectos a batería esa cifra importa más que los tokens por segundo.
Personalización para Chile
En Chile consigues las placas de este benchmark en MechatronicStore. Si vas a comprar una sola, que sea con PSRAM:
- Placa de desarrollo ESP32-S3 N16R8: la más rápida del ensayo y la más cómoda para desarrollar, con 16 MB de Flash para guardar varios modelos.
- XIAO ESP32-S3: rinde lo mismo que la N16R8 en un formato mínimo, ideal si el proyecto va dentro de una carcasa o funciona a batería.
- ESP32-CAM con su programador USB: la forma más económica de tener PSRAM, y además suma cámara para proyectos de visión.
- ESP32 DevKit V1: sirve para comparar y para aprender, pero para este tipo de IA es la opción más lenta.
- Cable USB de datos (no solo de carga): sin él la placa no aparece en Arduino IDE, un problema que parece de drivers y no lo es.
Si en el tutorial original usan la "ESP32-S3 DevKit N16R8" de otra marca, cualquier ESP32-S3 con 8 MB de PSRAM octal cumple la misma función: lo que define la velocidad es la PSRAM, no el fabricante de la placa.
Recursos
- Tutorial original (inglés), en el que se basa esta guía: ESP32 Tiny LLM Benchmark: 4 Boards, PSRAM vs Flash, de Circuit Digest
- Repositorio GitHub: Circuit Digest/ESP32-Tiny LLM
- Archivos descargables: código y modelos en .zip
- Plugin de LittleFS para Arduino IDE 2: arduino littlefs upload (releases)
- Documentación adicional: llama2.c de Andrej Karpathy, el motor en C del que sale el modelo
Versión chilena con componentes en stock local en MechatronicStore.